 Nexa
可追溯
一个结论,应能找到对应的输入、规则与版本。原典、传统解释和针对具体处境的解读,各有清楚的来源。
从传统规则,走向可追溯的解读。
八字与易经提供观察框架,数学模型刻画结构与变化,AI 将推演联系到你的问题。Nexa 的算法设计,把这三者连接起来。
算法设计与研究方向
7 个模块、24 组公式,分别处理比例、关系、时间与解释。每个模块承担一个明确的推演任务。
将资料处理、结构计算和语言解释分层:先形成推演依据,再组织回答。规则版本与不确定性随结果保留,便于追溯同一个判断。
让解读有清楚的来由。
先确认资料,再进行结构推演,整理依据,最后才组织回答。版本与不确定性也需要跟着结果留下,让你知道这份解读从哪里来。
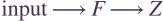
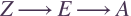

符号定义F 是事实处理,Z 是结构计算,E 是依据,A 是解释;V 代表所用版本,U 代表不确定性。箭头表示处理顺序,不是因果效力的证明。
适用条件AI 不应自行补算历法或改写已记录的起卦结果。
同一份输入,先经过事实与规则计算,产生依据和不确定性。AI 接着把这些内容与你的问题放在一起,整理成可以阅读的回答。
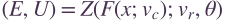
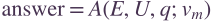
符号定义x 是原始输入;F(x;v_c) 是事实变换;Z 是结构计算;E、U 是依据与不确定性;q 是你的问题。v_c、v_r、v_m 分别是历法、规则与语言模型版本;θ 是内部参数。
适用条件公式描述数据与计算之间的依赖关系。AI 的解释应以 E 中的依据为基础,不能改动其中的计算事实。
解读应带着自己的版本记录。日后规则或参数改变,可以比较是哪一部分造成差异,而不把前后不同的回答当作同一次计算。
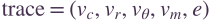
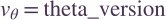
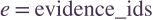
符号定义trace 是追溯记录;v_c、v_r、v_m 是历法、规则、语言模型版本;v_θ 与 theta_version 都表示参数版本;e 与 evidence_ids 都表示依据项目的识别码。
适用条件版本名称与识别码不能取代实际记录。能否重算,还取决于原始数据、各版本及必要的生成记录是否被保留并可存取。
将五行表示为总和为 1 的相对组成,用对数比刻画内部关系,以 Aitchison 距离比较结构差异;多个来源通过加权几何中心融合。
关注整体比例,而不只是一项多或少。
这套模型把木、火、土、金、水表示为相对比例。总和固定为一,所以一项增加时,其他项的相对比例也会受到影响。
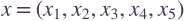
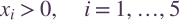
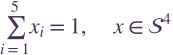
符号定义x_i 是第 i 个分量的比例;S⁴ 表示五个分量、四个自由维度的单纯形。这里用其各分量严格为正的内部,供后续对数计算。
适用条件原始数据若有零值,需要先依明确且可追溯的规则处理,不能直接取对数。
先找出各分量的几何中心,再看每一项相对这个中心的对数比例。两个状态的距离,就在这个比例空间里比较。
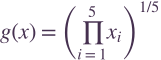
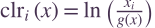
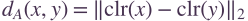
符号定义g 是几何平均;clr 是中心对数比;ln 是自然对数;d_A 是 Aitchison 距离;‖·‖₂ 是欧氏范数;x、y 是两个组成。
适用条件x、y 的每个分量都必须大于零。距离大表示比例结构差异大,不能直接解读成好或坏;零值替换与数值精度需要另外记录。
本命、时间与季节等来源,先依各自权重做几何融合,再把总和调整为一。这让比较保留相对比例,而不被某个来源的原始总量带走。
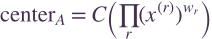
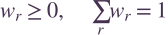

符号定义x^(r) 是第 r 个来源;w_r 是其权重;乘积与次方逐分量计算;C 是闭合或正规化操作;z 是尚未闭合的向量。
适用条件来源分量须符合正值要求;闭合分母必须大于零。权重需有版本与依据;融合公式本身不能决定哪个来源更可信。
集中度描述比例是否偏向少数分量,位移描述目前与背景相差多少。它们回答的是结构问题,解读方向还要看传统关系与你所问的事。
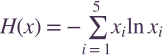
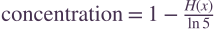

符号定义H 是熵;ln5 是五个分量平均分布时的最大熵;current、background 分别是目前与背景状态;d_A 沿用前一组距离。
适用条件比例需正且总和为一;零值下的熵可用极限处理,但 Aitchison 距离仍需正值。集中度在 0 到 1 之间,集中或位移较大都不等于吉凶分数。
必要条件决定一条规则是否适用,连续评分描述成立后的程度。有向关系保留作用的起点、终点与路径,使位置、组合和方向进入同一个计算框架。
同一个特征,在不同条件下可以有不同含义。
先判断必要条件是否成立,再讨论程度。条件不成立时,门控值为零;即使其他指标很高,也不能把这个结构说成已经成立。
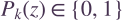
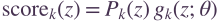
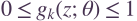
符号定义z 是待判断的结构;k 是结构类别;P_k 是必要条件的布尔判定;g_k 是通过条件后的程度函数;θ 是其参数。
适用条件P_k 的定义取决于采用的来源、流派与版本,不能由分数高低反推。score 是内部结构量,并非事件发生概率。
同一对对象,作用方向不同,意义也可能不同。有向图把两个方向分开保留,避免把同时存在的不同作用压成一个没有方向的标签。
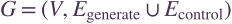
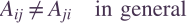
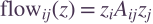
符号定义G 是图;这里的 V 是节点集合,并非前文的版本;E_generate、E_control 是生与克的边;A_ij 是 i 对 j 的作用强度;z_i、z_j 是参与分量。
适用条件A 不必对称;相反方向的信号可以同时存在,不能自动互相抵消。
两个术语同时出现,还不足以确认一种关系成立。需要知道谁参与、方向如何、必要条件是否满足,以及作用路径是否存在。
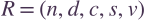
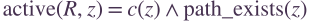
符号定义R 是关系记录;n、d、c、s、v 依序是参与者、方向、条件、来源、版本;c(z) 与 path_exists(z) 都是布尔判定;∧ 表示两项同时为真。
适用条件配对、完整成员集合与作用路径可能需要不同规则。这个共同界面不能抹去它们的差异;触发与未触发情况都需要可核对的样例。
以真实重叠时长分配跨周期权重,分别观察平均状态、波动、位移和转向。年、月、日的影响在同一条时间路径上比较。
把眼前的变化,放回更长的时间背景。
一段时间从起点算起,到下一段起点之前结束。若另一个周期在中途切换,就依真正重叠了多久分配权重。研究日运时,也要注意干支与星期周期每 420 日重合,避免把普通日历效应误认为模型效果。
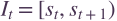
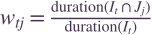

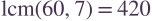
符号定义I_t 是目前区间,s_t 是其起点;J_j 是与它重叠的其他周期;duration 是时长;w_tj 是覆盖权重;lcm 是最小公倍数。60 日与 7 日周期的最小公倍数为 420 日。
适用条件I_t 时长需大于零,J_j 必须无重无漏地覆盖它,权重总和才为一。时区与节气边界要先统一。
先把每期组成放进同一个对数比空间,再量出相邻期间的位移。位移长度描述变化大小;相邻位移的夹角则帮助观察方向是否改变。

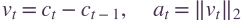
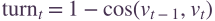
符号定义x_t 是第 t 期组成;c_t 是其 clr;v_t 是位移向量;a_t 是位移长度;cos 是两向量的余弦相似度;turn_t 是转向指标。
适用条件clr 要求正分量;任一位移为零向量时,余弦相似度没有定义,需标示无法判定或依明确的处理规则处理。转向门槛需经过校准。
把作用的总强度与方向分开保留。两股相反的作用都很强时,总活动量可以很高,而合起来的方向仍接近零。
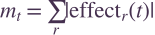
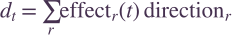
符号定义effect_r(t) 是第 r 种作用在 t 时刻的量;direction_r 是其方向向量;m_t 是绝对值总和;d_t 是方向合成。
适用条件各作用需有一致的量尺与方向定义。d_t 接近零不表示没有作用;m_t 与 d_t 都不是事件发生概率。
模糊隶属度描述边界过渡,扰动分析检查输入微调后判断是否稳定,信息不足时收缩结论范围。事件概率需要独立校准,不能用内部评分替代。
识别哪些判断稳固,哪些依赖尚未确定的条件。
非常接近的数据,不必因跨过一道硬门槛就得到完全相反的描述。隶属度表示它接近各状态的程度,再把候选结果连续地融合。
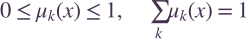
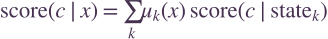
符号定义μ_k(x) 是输入 x 对状态 k 的隶属度;c 是候选项;state_k 是第 k 种状态;score 是该状态下的内部分数。
适用条件总和为一是这里的融合约定,并非所有模糊集合自动具备。隶属度不是事件概率,也不能新增原规则没有的判断;函数形状仍需版本与校准。
在合理的输入误差内重算多次,看看某个候选有多少次仍在前 K 名。若它经常掉出前列,就应让你看到其他可能与敏感的数据来源。

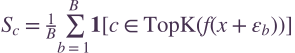
符号定义f 是排序函数;ε_b 是第 b 次扰动;D_η 是允许误差的分布;B 是重算次数;K 是保留名次数;1[·] 在条件成立时为一,否则为零;S_c 是稳定率。
适用条件B 须为正整数,K 需在候选数量内,扰动后数据仍须合法。S_c 取决于选定误差模型,不是职业成功率、事件概率或命理准确率。
资料不完整时,将显示值往中性参考收回一些,避免让不充分的依据呈现得过度精确。这是在缩小判断,不是在否定你。
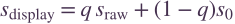

符号定义此处 q 是依据完整程度,不是用户问题;s_raw 是原始内部分,s₀ 是中性参考,s_display 是展示值。
适用条件完整程度与中性点需有明确定义,分数量尺需一致。q 低不表示职业或关系不适合;严重缺数据时,可以不给精细排名。
对事先定义的事件提出概率后,需要拿真实结果评估。Brier 衡量概率与结果的平方差;Log Loss 会对过度自信的错判给出更大代价。
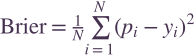
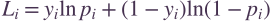
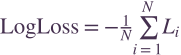
符号定义N 是样本数,p_i 是第 i 个事件的预测概率,y_i 是实际结果 0 或 1。L_i 是第 i 个样本在预测概率下的对数似然;Log Loss 是这些值的负平均。
适用条件N 必须大于零;直接计算对数时要求 0<p_i<1,端点需用极限或有记录的数值处理。评估需独立留出数据,并看校准曲线;罕见事件另报基准率、precision、recall、PR-AUC。高准确率不能替代校准,内部分数也不能直接改名为概率。
以状态表示、条件转移和联合概率描述六步爻值生成。每一步只使用当时已知的信息,并保留完整生成记录;关闭观察耦合时,回到指定的传统独立基准。
把起卦生成与后续解读分开研究。
OCQM-6 的研究表示,用密度矩阵整理状态,再由对应的投影读出四种爻值的概率。每个概率都不能为负,加起来必须等于一。
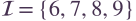
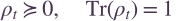
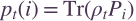
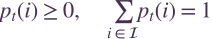
符号定义I 是内部爻值集合;ρ_t 是第 t 步密度矩阵;P_i 是状态 i 的投影算子;Tr 是矩阵的迹;p_t(i) 是相应概率;≽0 表示半正定。
适用条件半正定是 Hermitian 矩阵的整体性质,不是每个元素都大于等于零。投影需构成完备且互斥的状态集合。这里采用量子概率的数学表示,不要求使用量子硬件。
目前的状态分布,通过依历史而定的转移核,形成下一步分布。观察信息可以进入研究模型,但每一次更新仍须保证概率合法。
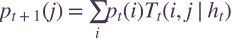
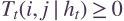
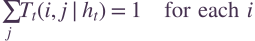
符号定义i、j 是前后状态;T_t 是条件转移核;h_t 包含截至 t 的结果、选择性观察状态与经过滤的上下文;p_t 是给定当前历史后的内部状态分布。此式不是无条件边际分布的恒等式。
适用条件每个固定历史下,T 的每一行都要非负并归一,不能只检查整张矩阵总和。这项性质让每一步的概率保持合法。
模型需要一个可以退回的比较起点。启用平稳校正时,传统基线经转移后维持不变;把观察耦合关掉时,则要精确回到各次独立生成的基线。

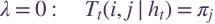
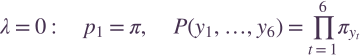
符号定义π 是指定的传统基线分布;T_t 是转移核;λ 表示观察耦合强度;y_t 是第 t 爻的值。λ=0 表示关闭观察耦合,此时初始分布与每一步转移都回到 π,六爻的联合概率等于各爻基线概率的乘积。
适用条件π 本身须非负且总和为一。平稳不等于独立;πT=π 不能取代关闭耦合后的精确回退。新机制还需与独立基线及较简单序列模型比较。
把每一步在当时历史下的概率相乘,才得到整个六爻序列的概率。这保留了前后步骤可能的依赖,让生成过程可以逐步检查。
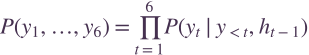
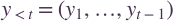
符号定义y₁到y₆ 是生成的爻值;y_<t 是当前步之前的序列;h_(t−1) 是已有历史;Π 表示逐步相乘。第一步使用起始历史 h₀。
适用条件每个条件分布都需合法,历史只能使用该步之前可得的信息。 此乘积依已指定的观察机制与上下文约定计算;若历史另含随机信息,需明确条件化或纳入联合模型,不能直接视为爻值的无条件联合概率。
同一次爻值生成完成后,先留下记录,再显示硬币画面。重新整理或网络重试应拿回同一笔结果,让你看到的解读有稳定起点。


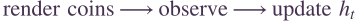

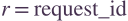
符号定义y_t 是已生成爻值;event 是保存的生成事件;h_t 是更新后历史;r 与 request_id 都是辨识同一请求的识别码。箭头表示生成、保存、显示、观察与更新的先后顺序。
适用条件重试不是重新抽取。硬币是条件显示;互卦、错卦、综卦等需由已生成六爻确定性推算,不能回写当轮生成状态。
将计算结果、规则、冲突与适用范围组织成依据包,再由 AI 联系问题解释。覆盖率、遗漏和矛盾分别检查,避免流畅的表达掩盖推演缺口。
让回答围绕推演依据展开。
AI 在回答前,先取得事实、规则、冲突与不确定性。它可以安排叙述顺序、解释意思,但不能因此改动计算事实,或替你补造未发生的事情。

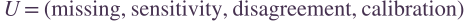
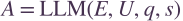

符号定义E 含事实、规则、冲突、适用范围与版本;U 含缺失、敏感性、分歧与校准信息;q 是问题;s 是安全政策;LLM 是语言模型;A 是回答。未满足的条件也须进入依据记录。
适用条件依据包需要能回到具体 evidence_ids;字段存在不代表内容充分。计算事实、传统解释、模型综合与现实建议仍需分清。
可以分别看:能核对的说法里,有多少得到支持;该交代的内容,有多少被漏掉;已检查的说法组合里,有多少互相矛盾。这让文字质量有具体可追问的地方。
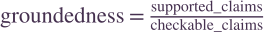
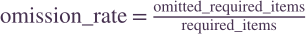
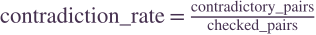
符号定义supported_claims、checkable_claims 是有支持与可核对的说法数;omitted_required_items、required_items 是遗漏与必须交代的项目数;contradictory_pairs、checked_pairs 是矛盾与已检查的成对说法数。
适用条件分母为零时应标示无法计算,不能填成零或满分;项目判定需一致,并配合人工盲审与用户研究。这些比率衡量忠实程度,不是命理的现实预测效度。
一个结论,应能找到对应的输入、规则与版本。原典、传统解释和针对具体处境的解读,各有清楚的来源。
输入略有变化时,重新比较结果。结构评分、稳定率与事件概率分别定义,避免不同指标被混为一谈。
AI 的解释连接推演与具体情境。你可以继续问原因、补充背景,逐步看清一个判断成立的条件。
这些公式描述 Nexa 的算法设计,不代表预测效果已经得到验证。OCQM-6 是六爻生成的研究模型,使用量子概率的数学表示,不涉及量子硬件。