 Nexa
追跡できる
一つの結論から、対応する入力・規則・バージョンをたどれること。原典、伝統的な解釈、個別の状況に即した解釈は、それぞれの出典を明確にします。
伝統の規則から、根拠をたどれる解釈へ。
四柱推命と易が物事を捉える枠組みを与え、数理モデルが構造と変化を表し、AI が推論をあなたの問いに結び付ける。Nexa のアルゴリズム設計は、この三つをつなぎます。
アルゴリズム設計と研究方針
7 つのモジュール、24 組の数式で、比率・関係・時間・解釈を扱います。それぞれのモジュールが、推論の中で明確な役割を担います。
入力処理、構造計算、言語による解釈を分離し、推論の根拠を整えてから回答を組み立てます。規則のバージョンと不確実性を結果に添えることで、一つの判断をたどれるようにします。
解釈の成り立ちを明確にする。
まず資料を確認し、構造を推論して根拠を整理し、最後に回答を組み立てます。バージョンと不確実性も結果に添えることで、解釈の成り立ちをたどれるようにします。
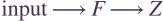
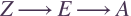

記号の定義F は事実の処理、Z は構造計算、E は根拠、A は解釈です。V は使用するバージョン、U は不確実性を表します。矢印は処理順序を示し、因果的な有効性の証明ではありません。
適用条件AI が暦の計算結果を作り足したり、記録済みの起卦結果を書き換えたりしてはいけません。
同じ入力に対して、まず事実の処理と規則に基づく計算を行い、根拠と不確実性を得ます。その後、AI がこれらをあなたの問いと結び付け、読める形の回答にまとめます。
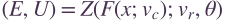
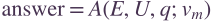
記号の定義x は元の入力、F(x;v_c) は事実への変換、Z は構造計算、E と U は根拠と不確実性、q はあなたの問いです。v_c、v_r、v_m はそれぞれ暦・規則・言語モデルのバージョン、θ は内部パラメータを表します。
適用条件数式はデータと計算の依存関係を記述します。AI の解釈は E に含まれる根拠に基づき、その中の計算上の事実を変更してはいけません。
解釈には、その計算に使ったバージョンの記録が必要です。後から規則やパラメータが変わった場合、結果の違いがどこから生じたのかを比較できます。異なる回答を、同じ条件での計算として扱わないためです。
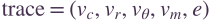
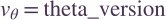
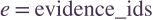
記号の定義trace は追跡記録です。v_c、v_r、v_m は暦・規則・言語モデルのバージョン、v_θ と theta_version はパラメータのバージョン、e と evidence_ids は根拠項目の識別子を表します。
適用条件バージョン名や識別子だけでは、実際の記録を代替できません。再計算できるかどうかは、元の入力、各バージョン、必要な生成記録が保存され、利用可能であることにも依存します。
五行を総和 1 の相対的な組成として表し、対数比で内部の関係を記述し、Aitchison 距離で構造の差を比較します。複数の情報源は加重幾何平均による中心に統合します。
一つの要素の多寡だけでなく、全体の比率を見る。
このモデルでは、木・火・土・金・水を相対的な比率で表します。総和を 1 に固定するため、一つの成分が増えると、他の成分の相対的な割合も変わります。
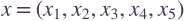
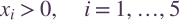
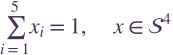
記号の定義x_i は第 i 成分の比率、S⁴ は五つの成分と四つの独立な次元を持つ単体です。後続の対数計算のため、ここでは各成分が厳密に正となる単体の内部を用います。
適用条件元のデータに 0 が含まれる場合、そのまま対数を取ることはできません。明確で追跡可能な規則に従い、事前に処理する必要があります。
まず成分の幾何平均を求め、各成分をその中心に対する対数比で表します。二つの状態の違いは、この比率の空間における距離として比較します。
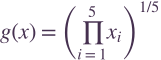
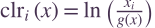
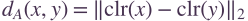
記号の定義g は幾何平均、clr は中心化対数比、ln は自然対数、d_A は Aitchison 距離、‖·‖₂ はユークリッドノルムです。x と y は比較する二つの組成を表します。
適用条件x と y の全成分が正である必要があります。距離が大きいことは比率構造の差が大きいことを示し、良し悪しを直接意味しません。ゼロ値の置換と数値精度は別途記録します。
出生時の命式、時期、季節などの情報源を、それぞれの重みに応じて幾何的に統合し、総和が 1 になるよう正規化します。これにより、一つの情報源の元の総量に左右されず、相対的な比率を比較できます。
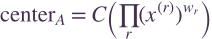
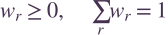

記号の定義x^(r) は第 r の情報源、w_r はその重みです。積と累乗は成分ごとに計算します。C は閉包化、すなわち正規化操作、z は閉包化前のベクトルを表します。
適用条件情報源の成分は正値の条件を満たし、閉包化の分母は正である必要があります。重みには根拠とバージョンが必要です。統合の数式だけでは、どの情報源がより信頼できるかは決まりません。
集中度は比率が少数の成分に偏っているかを表し、変位は現在の組成が背景となる組成からどれほど離れているかを表します。いずれも構造の指標であり、その解釈には伝統的な関係とあなたの問いも関わります。
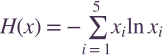
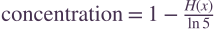

記号の定義H はエントロピー、ln5 は五成分が均等なときの最大エントロピーです。current と background は現在と背景の状態、d_A は前項で定義した距離を表します。
適用条件比率は正で、総和は 1 である必要があります。エントロピーでは 0 を極限で扱えますが、Aitchison 距離には正値が必要です。集中度は 0 から 1 の範囲であり、集中や変位の大きさは吉凶の点数ではありません。
必要条件によって規則の適用可否を判断し、成立した後の程度を連続的なスコアで表します。有向関係には作用の起点・終点・経路を残し、位置・組み合わせ・方向を共通の計算枠組みで扱います。
同じ特徴でも、条件によって意味は変わる。
まず必要条件が成立するかを判断し、その後に程度を評価します。条件を満たさなければゲート値は 0 です。他の指標が高くても、その構造が成立したとは判断しません。
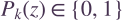
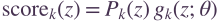
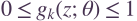
記号の定義z は判定する構造、k は構造の種類、P_k は必要条件を判定するブール関数、g_k は条件を満たした後の程度関数、θ はそのパラメータです。
適用条件P_k の定義は、採用する出典・流派・バージョンに依存します。得点の高さから逆算することはできません。score は内部的な構造量であり、事象が起こる確率ではありません。
同じ二つの対象でも、作用の方向が違えば意味も変わることがあります。有向グラフでは両方向を別々に保持し、同時に存在する異なる作用を、方向のない一つのラベルにまとめないようにします。
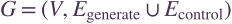
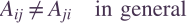
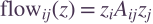
記号の定義G はグラフです。ここでの V は頂点集合であり、前出のバージョンではありません。E_generate と E_control は相生と相剋の辺、A_ij は i から j への作用強度、z_i と z_j は関与する成分です。
適用条件A は対称である必要はありません。反対方向の作用が同時に存在する場合もあり、自動的に相殺してはいけません。
二つの用語が同時に現れるだけでは、関係の成立は確認できません。何が関与するのか、方向はどうなっているか、必要条件を満たすか、作用経路が存在するかを確認します。
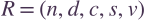
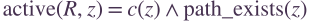
記号の定義R は関係の記録です。n、d、c、s、v は順に関与する要素・方向・条件・出典・バージョンを表します。c(z) と path_exists(z) はブール判定、∧ は両条件がともに真であることを示します。
適用条件組み合わせ、構成要素の集合全体、作用経路には、それぞれ異なる規則が必要な場合があります。共通のインターフェースでその差を失わないようにし、成立する場合と成立しない場合の両方に検証可能な例を用意します。
実際に重なる時間の長さに応じて周期間の重みを配分し、平均状態・変動・変位・方向転換をそれぞれ観察します。年・月・日の影響を、同じ時間軌道上で比較します。
目の前の変化を、より長い時間の中に位置付ける。
時間区間は始点を含み、次の区間の始点を含まないものとします。別の周期が途中で切り替わる場合、実際に重なる長さに応じて重みを配分します。日運の研究では、干支と曜日の周期が 420 日ごとに重なる点にも注意し、通常の暦の影響をモデルの効果と取り違えないようにします。
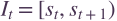
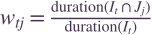

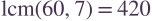
記号の定義I_t は現在の区間、s_t はその始点、J_j は重なる別の周期、duration は時間の長さ、w_tj は重なりの重み、lcm は最小公倍数です。60 日周期と 7 日周期の最小公倍数は 420 日です。
適用条件I_t の長さは正である必要があります。重みの総和を 1 にするには、J_j が重複も抜けもなく I_t を覆う必要があります。時刻帯と節気の境界を先に統一します。
各期間の組成を同じ対数比空間に置き、隣接する期間の変位を測ります。変位の長さは変化の大きさを、連続する変位のなす角は方向が変わったかを捉える手掛かりになります。

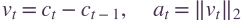
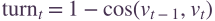
記号の定義x_t は第 t 期の組成、c_t はその clr、v_t は変位ベクトル、a_t は変位の長さ、cos は二つのベクトルのコサイン類似度、turn_t は方向転換の指標です。
適用条件clr には正の成分が必要です。いずれかの変位がゼロベクトルの場合、コサイン類似度は定義されません。判定不能と表示するか、明示した規則に従って処理します。方向転換の閾値には校正が必要です。
作用の総強度と方向を別々に保持します。反対方向の二つの作用がどちらも強ければ、総活動量は大きくても、合成された方向成分は 0 に近くなる場合があります。
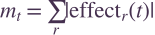
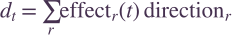
記号の定義effect_r(t) は時刻 t における第 r の作用量、direction_r はその方向ベクトル、m_t は絶対値の総和、d_t は方向を考慮した合成値です。
適用条件各作用の尺度と方向の定義をそろえる必要があります。d_t が 0 に近くても、作用がないとは限りません。m_t も d_t も、事象の発生確率ではありません。
ファジィ所属度で境界付近の連続的な変化を表し、摂動解析で入力の微小な変化に対する判断の安定性を調べます。情報が不足する場合は結論の範囲を絞ります。事象の確率には独立した検証による校正が必要で、内部スコアでは代用できません。
安定した判断と、未確定の条件に依存する判断を分ける。
非常に近いデータが、固定の閾値をまたいだだけで正反対の説明になる必要はありません。所属度で各状態への近さを表し、候補となる結果を連続的に統合します。
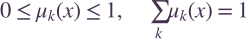
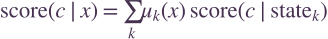
記号の定義μ_k(x) は入力 x の状態 k に対する所属度、c は候補、state_k は第 k の状態、score はその状態における内部スコアです。
適用条件総和を 1 とするのは、ここで採用する統合上の規約です。すべてのファジィ集合が自動的にこの性質を持つわけではありません。所属度は事象の確率ではなく、元の規則にない判断も追加できません。関数の形にはバージョン管理と校正が必要です。
合理的な入力誤差の範囲で何度も再計算し、ある候補が上位 K 件に残る回数を調べます。上位から外れることが多ければ、他の可能性や、結果が敏感に反応するデータを示す必要があります。

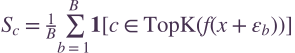
記号の定義f は順位付け関数、ε_b は第 b 回の摂動、D_η は許容誤差の分布、B は再計算回数、K は残す候補数です。1[·] は条件が成立するとき 1、それ以外は 0 となる指示関数、S_c は安定率です。
適用条件B は正の整数、K は候補数の範囲内でなければなりません。摂動後のデータも有効な条件を満たす必要があります。S_c は選んだ誤差モデルに依存し、職業上の成功率、事象の確率、命理の的中率を表すものではありません。
情報が不完全なときは、表示値を中立的な基準へ少し戻し、限られた根拠が過度に精密に見えないようにします。これは判断の範囲を狭める処理であり、あなたを否定するものではありません。
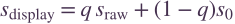

記号の定義ここでの q は根拠情報の充足度であり、利用者の問いではありません。s_raw は元の内部スコア、s₀ は中立的な基準、s_display は表示値です。
適用条件充足度と中立点を明確に定義し、スコアの尺度をそろえる必要があります。q が低いことは、職業や関係が不向きであることを意味しません。情報が著しく不足する場合は、細かな順位を示さない選択もあります。
あらかじめ定義した事象の確率は、実際の結果に照らして評価する必要があります。Brier スコアは確率と結果の差の二乗を測り、Log Loss は過度に自信のある誤予測に大きな損失を与えます。
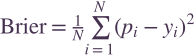
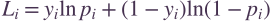
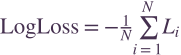
記号の定義N は標本数、p_i は第 i 事象の予測確率、y_i は 0 または 1 の観測結果です。L_i は予測確率の下での第 i 標本の対数尤度、Log Loss はそれらの負の平均です。
適用条件N は正である必要があります。直接対数を取るには 0<p_i<1 が必要で、端点には極限または記録された数値処理を用います。独立に取り分けた評価データと校正曲線が必要です。まれな事象では基準率、適合率、再現率、PR-AUC も報告します。高い正解率で校正を代替することはできず、内部スコアをそのまま確率と呼ぶこともできません。
状態表現、条件付き遷移、同時確率によって、6 段階の爻値生成を記述します。各段階ではその時点までに得られた情報だけを使い、生成の全記録を保持します。観測結合を無効にすると、指定した伝統的な独立生成の基準に戻ります。
卦の生成と、その後の解釈を分けて研究する。
OCQM-6 の研究上の表現では、密度行列で状態を整理し、対応する射影から四種類の爻値の確率を得ます。各確率は非負で、総和は 1 でなければなりません。
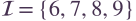
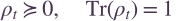
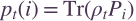
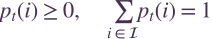
記号の定義I は内部の爻値の集合、ρ_t は第 t 段階の密度行列、P_i は状態 i への射影作用素、Tr は行列のトレース、p_t(i) は対応する確率です。≽0 は半正定値を表します。
適用条件半正定値性はエルミート行列全体の性質であり、すべての要素が非負という意味ではありません。射影は完全で相互に排他的な状態集合を構成する必要があります。ここでは量子確率の数学的表現を用いており、量子ハードウェアは必要ありません。
現在の状態分布に、履歴に依存する遷移核を適用して次の分布を得ます。観測情報を研究モデルに取り入れる場合も、更新のたびに確率の妥当性を保つ必要があります。
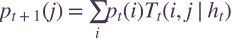
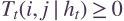
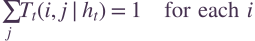
記号の定義i と j は遷移前後の状態、T_t は条件付き遷移核です。h_t は t までの結果、選択的な観測状態、フィルタリング済みの文脈を含みます。p_t は現在の履歴を条件とした内部状態分布です。この式は、無条件の周辺分布についての恒等式ではありません。
適用条件各固定履歴の下で、T の各行は非負かつ総和 1 である必要があります。行列全体の総和だけを確認しても不十分です。この条件によって、各段階の確率の妥当性を保ちます。
モデルには、戻ることのできる比較基準が必要です。定常補正を有効にした場合、伝統的な基準分布は遷移後も変わりません。観測結合を無効にした場合は、各回を独立に生成する基準へ正確に戻る必要があります。

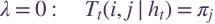
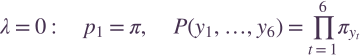
記号の定義π は指定した伝統的な基準分布、T_t は遷移核、λ は観測結合の強さ、y_t は第 t 爻の値です。λ=0 は観測結合を無効にすることを表します。このとき初期分布と各段階の遷移は π に戻り、六爻の同時確率は各爻の基準確率の積になります。
適用条件π 自体も非負で総和 1 でなければなりません。定常性は独立性とは異なるため、πT=π だけでは結合無効時の正確な復帰を保証できません。新しい仕組みは、独立生成の基準や、より単純な系列モデルとも比較する必要があります。
各段階で、その時点の履歴を条件とした確率を掛け合わせ、六爻系列全体の確率を求めます。これにより、段階間にあり得る依存関係を保ち、生成過程を順に確認できます。
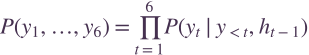
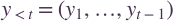
記号の定義y₁ から y₆ は生成された爻値、y_<t は現在の段階より前の系列、h_(t−1) は利用可能な履歴、Π は各段階にわたる積です。最初の段階では初期履歴 h₀ を用います。
適用条件すべての条件付き分布が有効でなければならず、履歴にはその段階より前に得られた情報だけを使います。この積は、指定した観測の仕組みと文脈の条件に基づきます。履歴に他の確率的情報を含む場合は、それを明示的に条件とするか同時モデルに組み込む必要があり、単に爻値の無条件同時確率とはみなせません。
爻値の生成後は、まず記録を保存し、それから硬貨の画面を表示します。再読み込みや通信の再試行では同じ結果を取得し、解釈の起点が変わらないようにします。


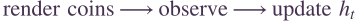

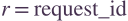
記号の定義y_t は生成済みの爻値、event は保存した生成イベント、h_t は更新後の履歴です。r と request_id は同じリクエストを識別する ID です。矢印は、生成・保存・表示・観測・更新の順序を示します。
適用条件再試行は引き直しではありません。硬貨は生成結果に条件付けられた表示です。互卦・錯卦・綜卦などは生成済みの六爻から決定論的に算出し、その回の生成状態を書き換えてはいけません。
計算結果・規則・矛盾・適用範囲を根拠パッケージにまとめ、AI が問いと結び付けて解釈します。網羅性、欠落、矛盾を個別に確認し、流暢な文章が推論の不足を覆い隠さないようにします。
推論の根拠に沿って回答を組み立てる。
AI は回答する前に、事実・規則・矛盾・不確実性を受け取ります。説明の順序を整え、意味を解説することはできますが、計算上の事実を変えたり、起きていない出来事を作り足したりしてはいけません。

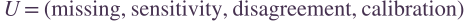
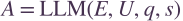

記号の定義E は事実・規則・矛盾・適用範囲・バージョンを、U は欠落・感度・見解の相違・校正情報を含みます。q は問い、s は安全方針、LLM は言語モデル、A は回答です。満たしていない条件も根拠の記録に含めます。
適用条件根拠パッケージから、具体的な evidence_ids をたどれる必要があります。項目が存在するだけでは内容が十分とは限りません。計算上の事実、伝統的な解釈、モデルによる統合、現実的な提案は区別します。
検証可能な主張のうち裏付けがあるもの、必要な説明のうち抜けているもの、確認した主張の組のうち矛盾するものを、それぞれ調べます。これによって、説明品質の具体的な側面を検討できます。
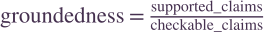
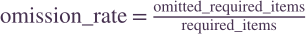
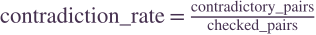
記号の定義supported_claims と checkable_claims は、裏付けのある主張数と検証可能な主張数です。omitted_required_items と required_items は欠落項目数と必要項目数、contradictory_pairs と checked_pairs は矛盾する主張の組数と確認した組数です。
適用条件分母が 0 の場合は計算不能とし、0 や満点を入れてはいけません。判定基準を一貫させ、人による盲検評価や利用者調査も組み合わせます。これらの比率が測るのは根拠への忠実さであり、命理の現実における予測妥当性ではありません。
一つの結論から、対応する入力・規則・バージョンをたどれること。原典、伝統的な解釈、個別の状況に即した解釈は、それぞれの出典を明確にします。
入力が少し変わった場合に、結果を再比較します。構造スコア、安定率、事象の確率を別々に定義し、異なる指標の混同を防ぎます。
AI の解釈は推論と具体的な状況をつなぎます。理由を尋ね、背景を補いながら、その判断が成り立つ条件を少しずつ明らかにできます。
これらの数式は Nexa のアルゴリズム設計を示すものであり、予測の有効性が検証済みであることを意味しません。OCQM-6 は六爻を生成する研究モデルです。量子確率の数学的表現を用いますが、量子ハードウェアは使用しません。